项目介绍 · 语音随手记 → 结构化记录
一个从真实痛点出发、持续使用、再系统性重建的记录产品。
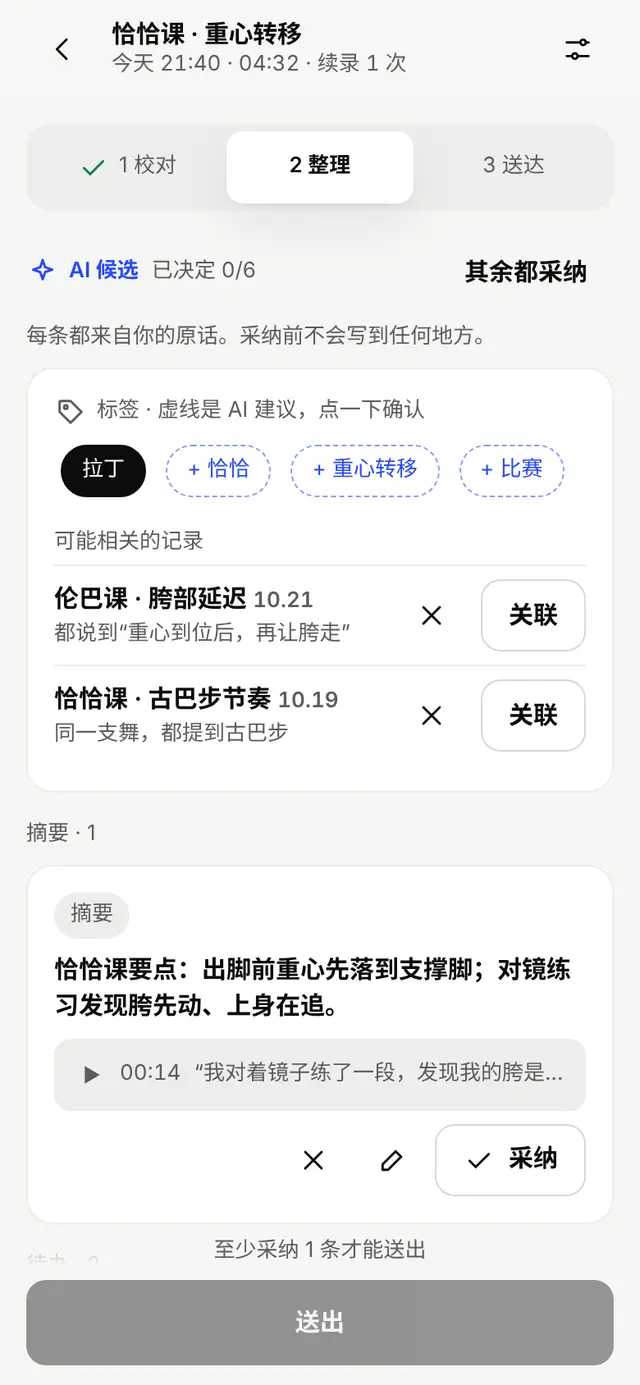
从重录、内容丢失与复制脆弱的真实使用问题出发,设计原话校对、候选裁决、分层送达与原声找回;新版界面与转写档位均作为产品设计方案展示。
需求演进隐私取舍分阶段交付
打开交互原型 ↗从原话到可核对的送达
Silu 思录
为什么做这个
路径从 2025 年 10 月的转录网页原型,到 2026 年 6 月随身麦克风接手机、再经飞书归档的自用链路,再到 9 月电话打断导致重录、内容分段后找不到、复制粘贴太脆弱,于是决定重建。新版目标是:让每段记录有清晰的状态,AI 派生内容可被人工确认,多个下游按各自规则接收。
要解决的痛点
- 随口说的想法容易散落在不同入口,之后难以找到
- 若 AI 摘要覆盖原话,用户失去核对语境的依据
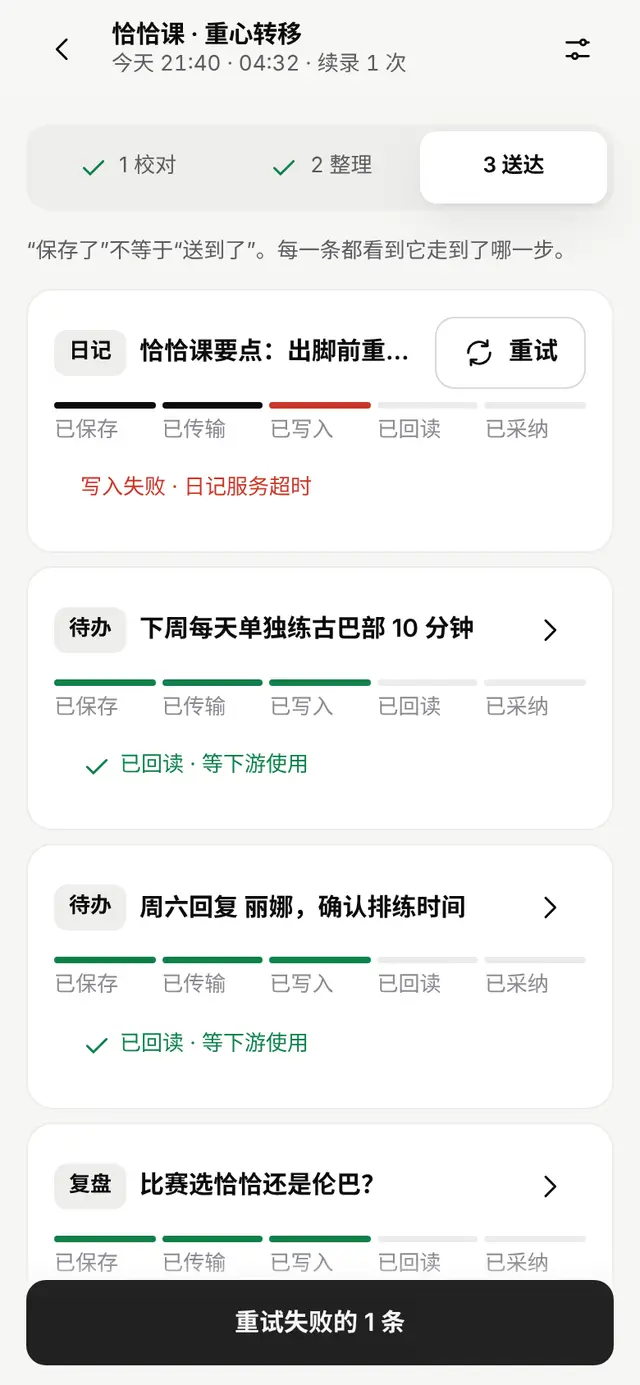
- 同一份记录在不同阶段的进度被一个"完成"状态掩盖
- 内容分段、复制粘贴后脆弱,难以找回与复用
用户体验流程
关键决策
选择 1
把"已保存 / 已传输 / 已写入 / 已回读 / 已采纳"拆成多个独立状态
放弃
用一个 done 状态表示完成
原因
同一份记录在不同阶段的真实进度不同,一个 done 会掩盖失败续接点
选择 2
原文永远不覆盖;人工修改或换模型重转都另存为新版本,可与原声对照
放弃
让 AI 摘要直接替换用户原话
原因
用户需要随时回到原始语境,区分"自己的话"和"系统整理"
选择 3
AI 负责转写、提候选、做检索引用;人负责确认事实、决定是否保留录音、决定什么进入下游
放弃
让模型自动决定长期知识结构
原因
个人记录的意义依赖用户自己的语境和判断
我的角色与能力
我负责
我从设备采集到长期归档梳理整条记录链路:定义原话版本、AI 派生内容与用户确认的边界,用状态分层(已保存 / 已传输 / 已写入 / 已回读 / 已采纳)作为核心数据模型,并实现本地采集与缓存、送达幂等回读;同时准备合成录音样本以规避隐私。
能力体现
把设备采集、本地缓存、版本化原话与人工确认组织成有来源、可复核、可恢复的记录系统。
AI 做了
方案中,AI 提供转写、候选与检索引用;演示中的助手行为用于呈现交互方案。
我做了
我负责定义来源关系、确认边界和状态分层,并准备合成录音样本。
成果与下一步
已完成
- 旧链从 2026-05 至 10 月持续自用,有 288 条语音来源记录(录音转文字 235 条,飞书妙记 53 条),覆盖 95 个不同日期
- 形成采集、AI 整理、人工回顾与下游复用的状态分层模型(判定表)
公开数据
2026 年 5 月 7 日至 10 月 21 日,旧链有 288 条语音来源记录(录音转文字 235 条,飞书妙记 53 条),覆盖 95 个不同日期2026-10-21
输入来源混合:文字、会议纪要、小红书分享、链接
继续看第一个亮点 →